스케일 아웃·스케일 인 완벽 정리 — AWS EC2와 Kubernetes
1. 전체 개념
스케일링(Scaling)은 트래픽 변화에 따라 시스템의 처리 용량을 조절하는 기술이다.
| 개념 | 설명 |
|---|---|
| Scale Up | 서버의 CPU, 메모리 등 사양 증가 |
| Scale Out | 서버 또는 Pod의 개수 증가 |
| Scale In | 서버 또는 Pod의 개수 감소 |
| Auto Scaling | 모니터링 지표와 정책에 따라 자동으로 확장·축소 |
| Load Balancing | 여러 서버에 요청 분산 |
| Graceful Shutdown | 진행 중인 작업을 가능한 한 정상적으로 마무리하고 종료 |
핵심은 트래픽이 증가하면 처리 자원을 증설하고, 트래픽이 감소하면 서비스를 안전하게 유지하면서 불필요한 자원을 제거하는 것이다.
2. AWS EC2 + ALB + ASG 환경
2-1. 구성요소
| 구성요소 | 역할 |
|---|---|
| CloudWatch | CPU 사용률, 요청 수 등 지표 수집 |
| Auto Scaling Group(ASG) | EC2 인스턴스 개수 자동 조절 |
| ALB | HTTP/HTTPS 트래픽 분산 |
| Target Group | 요청 전달 대상 서버 관리 |
| Health Check | 서버 정상 상태 확인 |
2-2. 스케일 아웃: 서버 증설
트래픽 증가
    ↓
CloudWatch 지표 수집
    ↓
ASG 스케일링 정책 평가
    ↓
신규 EC2 생성
    ↓
애플리케이션 실행
    ↓
ALB Target Group 자동 등록
    ↓
Health Check 통과
    ↓
신규 서버로 트래픽 분산
예를 들어 EC2 2대에서 3대로 증설한다고 가정한다.
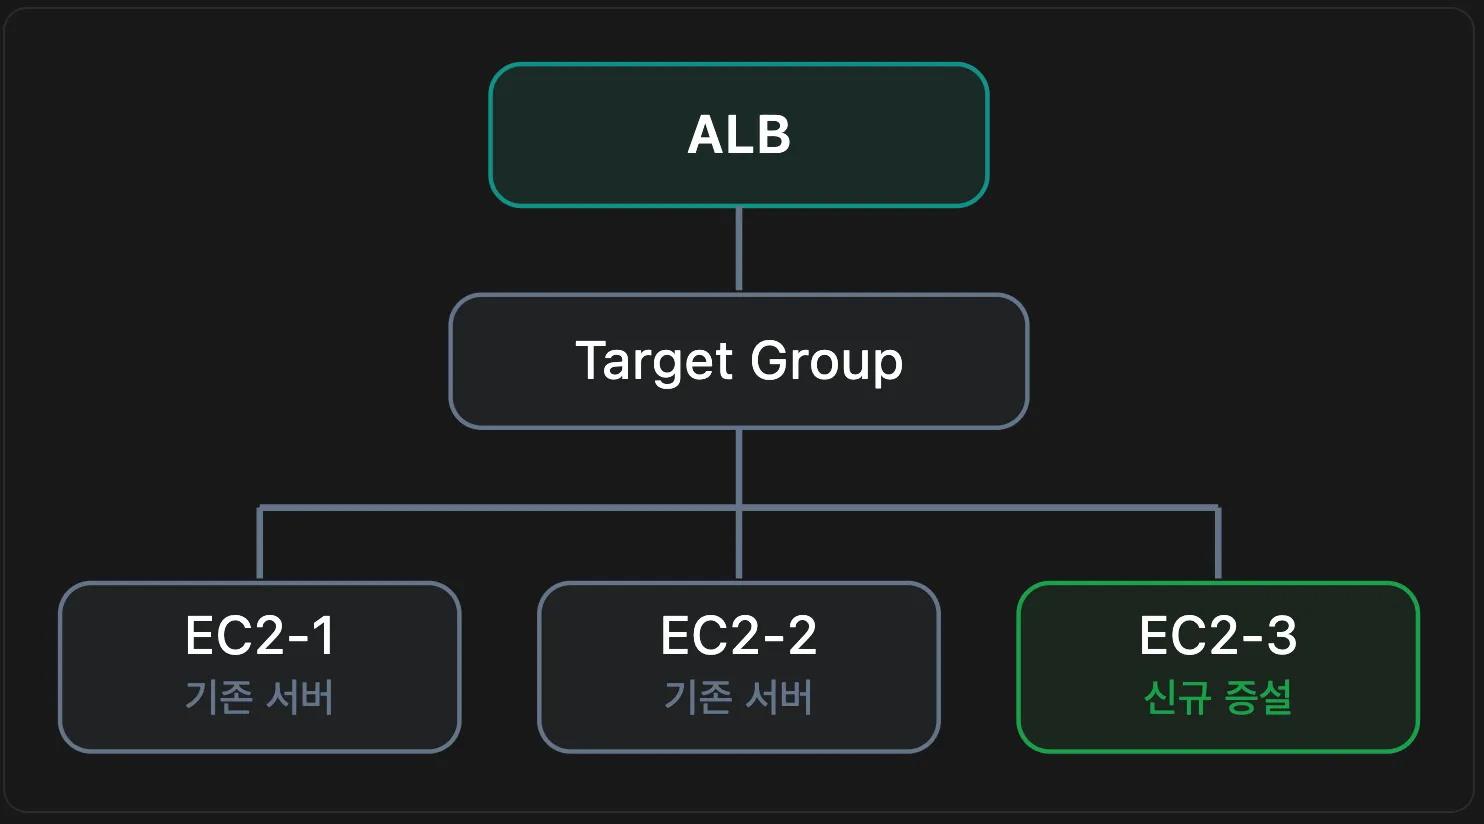
ASG가 Target Group과 연결되어 있다면 신규 EC2는 자동으로 등록된다.
개발자가 서버 IP를 매번 수동으로 등록할 필요가 없다.
2-3. 스케일 인: 서버 축소
트래픽이 감소하면 ASG가 불필요한 EC2를 제거한다.
트래픽 감소
    ↓
ASG 스케일링 정책 평가
    ↓
종료할 EC2 선정
    ↓
Target Group 등록 해제
    ↓
Connection Draining
    ↓
기존 요청·연결 정리
    ↓
애플리케이션 정상 종료
    ↓
EC2 종료
중요한 것은 EC2가 요청을 처리하는 도중 강제로 종료되지 않도록 하는 것이다.
ALB의 Connection Draining과 애플리케이션의 Graceful Shutdown을 적절히 조합해야 한다.
ASG의 실제 종료 과정은 설정에 따라 달라지므로, 애플리케이션 종료까지 충분한 시간이 필요하다면 Lifecycle Hook을 사용할 수 있다.
3. Connection Draining과 Graceful Shutdown
3-1. Connection Draining
Connection Draining은 로드 밸런서가 종료 예정 서버로 새로운 요청을 전달하지 않고, 기존 요청과 연결을 정리할 시간을 제공하는 방식이다.
AWS ALB에서는 Target Group의 deregistration_delay.timeout_seconds 속성을 이용한다.
기본값은 300초이다.
              ALB
               |
       +-------+-------+
       |               |
       v               v
    EC2-1            EC2-2
    Healthy          Draining
       |               |
    새 요청 처리     기존 요청 마무리
                       |
                       v
                  연결 정리 후 종료
ALB가 Draining 상태인 대상으로 새로운 일반 요청을 전달하지 않도록 하는 것이 핵심이다.
다만 이 설정만으로 애플리케이션 내부의 모든 작업이 완료되는 것은 아니다.
3-2. Graceful Shutdown
Graceful Shutdown은 애플리케이션이 종료 신호를 받았을 때 진행 중인 요청과 작업을 가능한 한 정상적으로 마무리한 후 종료하는 방식이다.
예를 들어 결제 요청을 처리하는 도중 서버가 종료된다면 요청이 중단될 수 있다.
Graceful Shutdown은 이러한 위험을 줄여준다.
애플리케이션 종료 신호
           ↓
새 요청 수락 중단 또는 제한
           ↓
기존 요청 처리 마무리
           ↓
리소스 정리
           ↓
프로세스 종료
Spring Boot에서는 다음과 같이 설정할 수 있다.
server:
  shutdown: graceful

spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
단, 30초 안에 모든 작업이 반드시 완료된다는 보장은 없다. 종료 유예 시간을 초과하거나 강제 종료가 발생하면 작업이 중단될 수 있다.
3-3. 두 기술의 차이
| 구분 | Connection Draining | Graceful Shutdown |
|---|---|---|
| 담당 | ALB | Spring Boot 등 애플리케이션 |
| 목적 | 새로운 트래픽 차단 및 기존 연결 정리 | 처리 중인 작업의 정상 종료 |
| 동작 위치 | 로드 밸런서 | 애플리케이션 프로세스 |
| 주요 설정 | Deregistration Delay | Graceful Shutdown Timeout |
Connection Draining은 외부 트래픽을 정리하고, Graceful Shutdown은 애플리케이션 내부 작업을 정리한다.
4. Kubernetes 환경의 Auto Scaling
Kubernetes에서는 애플리케이션의 확장과 인프라의 확장을 구분해야 한다.
| 구성요소 | 역할 |
|---|---|
| HPA | Pod 개수 자동 조절 |
| Deployment | 원하는 Pod 개수 유지 |
| Scheduler | Pod를 실행할 Node 선택 |
| Service | Pod에 접근하기 위한 안정적인 네트워크 진입점 |
| EndpointSlice | Pod IP 및 엔드포인트 정보 관리 |
| Cluster Autoscaler | ASG 등 기존 노드 그룹을 확장·축소 |
| Karpenter | Pod 요구사항에 따라 EC2 직접 프로비저닝 및 노드 관리 |
4-1. Kubernetes 스케일 아웃
트래픽 증가
    ↓
Metrics Server 등에서 지표 수집
    ↓
HPA가 Replica 수 증가 결정
    ↓
Deployment가 신규 Pod 생성
    ↓
Scheduler가 Node에 Pod 배치
    ↓
Pod가 Ready 상태로 전환
    ↓
EndpointSlice 정보 갱신
    ↓
Service를 통해 트래픽 분산
예를 들어 Pod가 2개에서 3개로 증가하면 Service의 Label Selector를 기반으로 신규 Pod가 연결 대상에 포함된다.
apiVersion: v1
kind: Service
metadata:
  name: spring-service
spec:
  selector:
    app: spring
  ports:
    - port: 80
      targetPort: 8080
여기서 중요한 것은 selector: app: spring이다.
Service는 Deployment의 이름이 아니라 Pod의 Label을 기준으로 대상을 선택한다.
4-2. Node 자원이 부족하면?
HPA는 Pod 개수만 조절한다.
기존 Node에 CPU나 메모리 여유가 없으면 신규 Pod가 Pending 상태로 남을 수 있다.
이때 Cluster Autoscaler나 Karpenter가 필요하다.
Cluster Autoscaler 사용 시
HPA → 신규 Pod 요청
          ↓
   Node 자원 부족
          ↓
   Pending Pod 발생
          ↓
  Cluster Autoscaler
          ↓
    ASG 용량 증가
          ↓
      EC2 생성
          ↓
   Kubernetes Node 등록
          ↓
      Pod 배치
Karpenter 사용 시
HPA → 신규 Pod 요청
          ↓
   Node 자원 부족
          ↓
   Pending Pod 발생
          ↓
       Karpenter
          ↓
    EC2 직접 생성
          ↓
   Kubernetes Node 등록
          ↓
      Pod 배치
Cluster Autoscaler는 기존 ASG 등을 활용하지만, Karpenter는 일반적으로 ASG 없이 EC2를 직접 생성한다.
5. Kubernetes 스케일 인
트래픽이 감소하면 Pod를 먼저 줄이고, 필요에 따라 Node도 제거한다.
트래픽 감소
    ↓
HPA가 Replica 수 감소 결정
    ↓
Deployment가 불필요한 Pod 종료
    ↓
Pod 종료 절차
    ├─ EndpointSlice에서 종료 상태 반영
    ├─ 새로운 요청 전달 대상에서 제외
    ├─ SIGTERM 전달
    └─ Graceful Shutdown
    ↓
Pod 종료 완료
    ↓
Cluster Autoscaler / Karpenter
    ↓
불필요한 Node 선정
    ↓
Node Drain
    ↓
필요한 Pod를 다른 Node에 재생성
    ↓
Node 종료
5-1. Stabilization Window
HPA가 트래픽이 잠깐 감소할 때마다 Pod를 즉시 줄이면 잦은 증설·축소가 발생할 수 있다.
이를 방지하기 위해 Stabilization Window를 사용한다.
기본 Scale Down 안정화 구간은 300초이다.
이는 최근 Replica 권장값을 고려해 급격한 축소를 방지하는 기능이다.
5-2. Kubernetes에서 Graceful Shutdown
Pod 종료 시 Kubernetes는 다음 절차를 수행한다.
- Pod에 종료 시각이 설정된다.
- EndpointSlice에서 종료 중인 Pod의 상태가 반영된다.
- 설정된
preStop훅이 있다면 실행된다. - 컨테이너 프로세스에 SIGTERM이 전달된다.
- 애플리케이션이 Graceful Shutdown을 수행한다.
- 종료 유예 시간이 지나면 필요에 따라 강제 종료된다.
설정 예시:
spec:
  terminationGracePeriodSeconds: 30
EndpointSlice 갱신과 종료 신호 전달은 일부 병렬로 진행되기 때문에, 두 과정이 완전히 순차적으로 실행된다고 가정하면 안 된다.
6. Node Drain과 Pod 재배치
Node Drain은 Node를 제거하기 전에 해당 Node에서 실행 중인 Pod를 안전하게 내보내는 작업이다.
중요한 점은 Kubernetes가 실행 중인 Pod를 다른 Node로 그대로 옮기는 것이 아니라는 것이다.
기존 Pod를 종료하고 새로운 Pod를 생성한다.
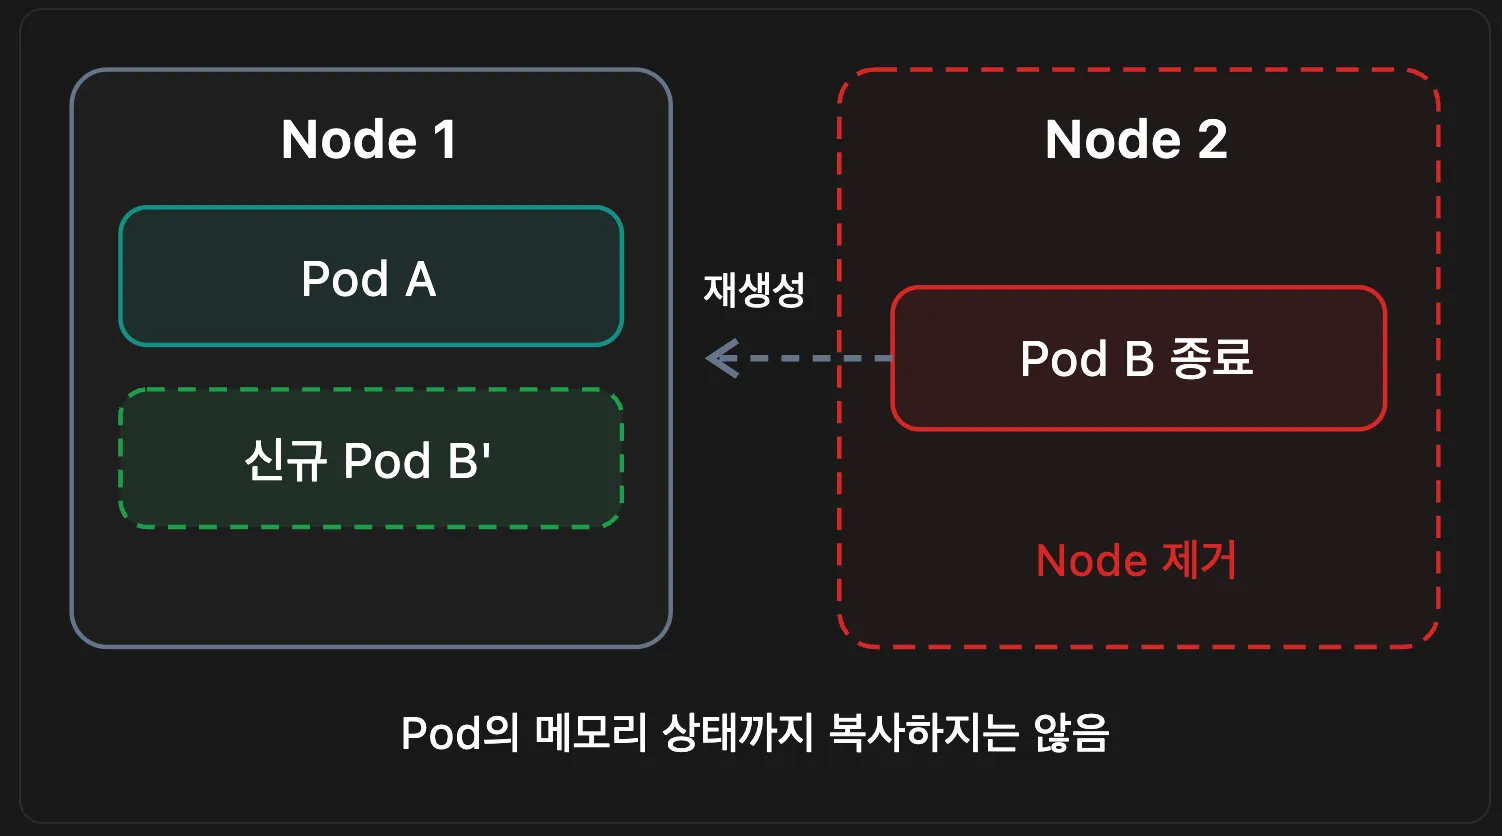
실제 흐름은 다음과 같다.
Node 제거 결정
      ↓
Cordon: 신규 Pod 배치 방지
      ↓
Drain: 기존 Pod Eviction 요청
      ↓
Pod Graceful Shutdown
      ↓
Deployment가 필요한 Pod 재생성
      ↓
Scheduler가 다른 Node 선택
      ↓
새 Pod Ready
      ↓
기존 Node 제거
실제로 Pod 종료와 신규 Pod 생성 과정은 일부 겹칠 수 있다.
관리자가 직접 Drain을 수행하는 명령어는 다음과 같다.
kubectl drain node-2 --ignore-daemonsets중요한 점: Pod의 데이터
Pod가 다른 Node에 재생성되어도 기존 Pod의 메모리 정보가 그대로 전달되지는 않는다.
따라서 애플리케이션을 Stateless하게 설계하는 것이 유리하다.
- 로그인 세션: Redis 등 외부 저장소
- 영속 데이터: 외부 DB
- 공유 파일: 적절한 영속 스토리지
- 장시간 작업: 재시도·복구 가능한 구조
6-1. PDB(PodDisruptionBudget)
Node Drain 중 여러 Pod가 동시에 종료되면 서비스 가용성이 떨어질 수 있다.
PDB는 Eviction API를 사용하는 자발적 중단 과정에서 유지해야 할 정상 Pod 수를 지정한다.
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: spring-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: spring
이 설정은 자발적 중단 시 정상 Pod를 최소 2개 유지하도록 보호한다.
단, PDB가 HPA의 Replica 축소 자체를 막아주는 것은 아니다.
7. AWS와 Kubernetes 최종 비교
| 구분 | AWS EC2 + ALB + ASG | Kubernetes |
|---|---|---|
| 확장 대상 | EC2 | Pod, 필요시 Node |
| 확장 결정 | ASG 스케일링 정책 | HPA, Node Autoscaler |
| 서버 생성 | ASG | Cluster Autoscaler 또는 Karpenter |
| 트래픽 분산 | ALB | Service 네트워킹 |
| 대상 목록 관리 | Target Group | EndpointSlice |
| 트래픽 제외 | Target Group Deregistration | EndpointSlice 상태 갱신 |
| 정상 종료 | Graceful Shutdown | Graceful Shutdown |
| 인프라 축소 | ASG | Cluster Autoscaler / Karpenter |
| 다른 서버로 이동 | 남은 EC2가 후속 요청 처리 | Pod 종료 후 다른 Node에 재생성 |
참고로 EKS에서 ALB를 함께 사용하는 경우에는 AWS Load Balancer Controller가 ALB Target Group과 Kubernetes Pod 또는 Node를 연결한다. IP 모드라면 Pod IP를 직접 등록할 수 있다.
8. 면접 예상 질문과 답변
Q1. 트래픽이 급증하면 어떻게 대응하겠습니까?
먼저 CPU 사용률, 응답 지연시간, DB 커넥션 수 등의 지표를 확인해 병목을 파악하겠습니다. 애플리케이션 서버의 처리 용량이 부족하다면 오토 스케일링을 통해 서버를 수평 확장하고, 로드 밸런서로 트래픽을 분산하겠습니다. 다만 DB가 병목이라면 캐싱이나 쿼리 최적화가 필요하므로, 단순히 서버를 늘리기보다 병목 원인에 맞게 대응하겠습니다.
Q2. AWS에서 오토 스케일링은 어떻게 동작하나요?
AWS에서는 CloudWatch가 CPU 사용률 등의 지표를 수집하고, Auto Scaling Group이 설정된 정책에 따라 EC2 인스턴스 수를 조절합니다. 신규 인스턴스는 연결된 ALB Target Group에 자동 등록되며, Health Check를 통과하면 트래픽을 받게 됩니다. 트래픽이 감소하면 반대로 불필요한 인스턴스를 제거해 비용을 절감할 수 있습니다.
Q3. Kubernetes에서는 오토 스케일링이 어떻게 동작하나요?
Kubernetes에서는 HPA가 CPU 사용률 등의 지표를 기반으로 Deployment의 Replica 수를 조절합니다. 새로운 Pod가 생성되면 Scheduler가 적절한 Node에 배치하고, Service와 EndpointSlice를 통해 트래픽 전달 대상에 포함됩니다. 다만 Node 자원이 부족하다면 Cluster Autoscaler나 Karpenter를 활용해 Node 자체를 증설해야 합니다.
Q4. 서버 축소 시 진행 중인 요청은 어떻게 처리하나요?
서버 축소 시에는 기존 요청이 중단되지 않도록 하는 것이 중요합니다. AWS에서는 ALB의 Deregistration Delay를 통해 종료 대상 서버로 새로운 요청을 전달하지 않고 기존 연결을 정리할 시간을 제공합니다. 또한 애플리케이션에 Graceful Shutdown을 적용해 진행 중인 요청을 마무리하도록 구성하겠습니다.
Q5. Kubernetes에서는 서버를 어떻게 안전하게 축소하나요?
HPA가 트래픽 감소에 따라 Replica 수를 줄이면 불필요한 Pod가 종료됩니다. 이때 Graceful Shutdown을 통해 기존 요청을 마무리하도록 구성합니다. 이후 Node 자원이 남으면 Cluster Autoscaler나 Karpenter가 제거할 Node를 판단하고, Drain을 통해 기존 Pod를 안전하게 종료하거나 다른 Node에 재생성한 뒤 Node를 제거합니다. 필요한 경우 PDB를 활용해 가용성을 보호할 수 있습니다.
Q6. Graceful Shutdown과 Connection Draining은 어떤 차이가 있나요?
Connection Draining은 로드 밸런서 수준에서 종료할 서버로 새로운 요청을 전달하지 않고 기존 연결을 정리하는 기술입니다. 반면 Graceful Shutdown은 애플리케이션 수준에서 진행 중인 요청을 마무리하고 정상적으로 종료하는 기술입니다. 따라서 두 기술은 서로 다른 계층에서 동작하며, 안전한 서버 축소를 위해 함께 활용할 수 있습니다.
9. 마지막 핵심 암기
| 키워드 | 한 줄 정리 |
|---|---|
| ASG | EC2 수 자동 조절 |
| ALB | 요청 분산 |
| Target Group | 요청 전달 대상 관리 |
| HPA | Pod 수 자동 조절 |
| Cluster Autoscaler | 기존 노드 그룹 확장·축소 |
| Karpenter | 필요한 EC2를 직접 생성·관리 |
| EndpointSlice | Service가 연결할 Pod 엔드포인트 관리 |
| Cordon | Node에 신규 Pod 배치 방지 |
| Drain | Node에서 기존 Pod를 안전하게 내보내기 |
| PDB | 자발적 중단 시 가용 Pod 수 보호 |
| Connection Draining | 로드 밸런서의 기존 연결 정리 |
| Graceful Shutdown | 애플리케이션의 진행 중인 작업 마무리 |
| Stabilization Window | 급격하거나 잦은 스케일링 방지 |
최종적으로 기억해야 할 흐름
[스케일 아웃]

AWS:
CloudWatch → ASG → EC2 생성 → Target Group → ALB

Kubernetes:
Metrics → HPA → Pod 생성 → Scheduler → Service
                              ↓
                      Node 자원 부족 시
                              ↓
                   CA / Karpenter → Node 증설


[스케일 인]

AWS:
ASG → Target Group 등록 해제
    → Connection Draining
    → Graceful Shutdown → EC2 종료

Kubernetes:
HPA → Pod 축소 → Graceful Shutdown
    → CA / Karpenter → Node Drain
    → 불필요한 Node 종료
면접의 핵심은 기술 이름을 많이 나열하는 것이 아니라, 증설·축소 과정에서 어떤 컴포넌트가 무엇을 담당하고 어떻게 서비스 가용성을 유지하는지 설명하는 것이다.