JPA 핵심 개념 총정리 — 질문 흐름 중심
지금까지 질문했던 내용을 ORM → 영속성 컨텍스트 → 엔티티 조회 및 저장 → Dirty Checking → flush → commit → 트랜잭션 → 예외 처리 순서로 정리할게.
이 흐름을 이해하면 JPA가 SQL을 언제 실행하고, 객체의 변경을 어떻게 관리하며, 예외가 언제 발생하는지 설명할 수 있어.
1. ORM과 JPA는 무엇인가?
**ORM(Object-Relational Mapping)**은 Java 객체와 관계형 DB 테이블을 매핑하는 기술이야.
@Entity
@Table(name = "products")
public class Product {

    @Id
    private Long id;

    private String name;
    private int price;
}- ORM: 객체와 테이블을 매핑하는 기술
- JPA: Java에서 ORM을 사용하기 위한 표준 명세
- Hibernate: JPA를 구현한 ORM 프레임워크
- Spring Data JPA: Repository 인터페이스로 JPA를 편리하게 사용하도록 해주는 기술
즉, JpaRepository를 사용하면 내부적으로 EntityManager와 Hibernate를 통해 DB에 접근하게 돼.
2. 영속성 컨텍스트란?
영속성 컨텍스트(Persistence Context)는 JPA가 엔티티를 관리하고 변경 사항을 DB와 동기화하는 논리적 공간이야.
ORM이 객체와 테이블의 매핑 관계를 정의한다면, 영속성 컨텍스트는 실제 객체의 상태를 관리해.
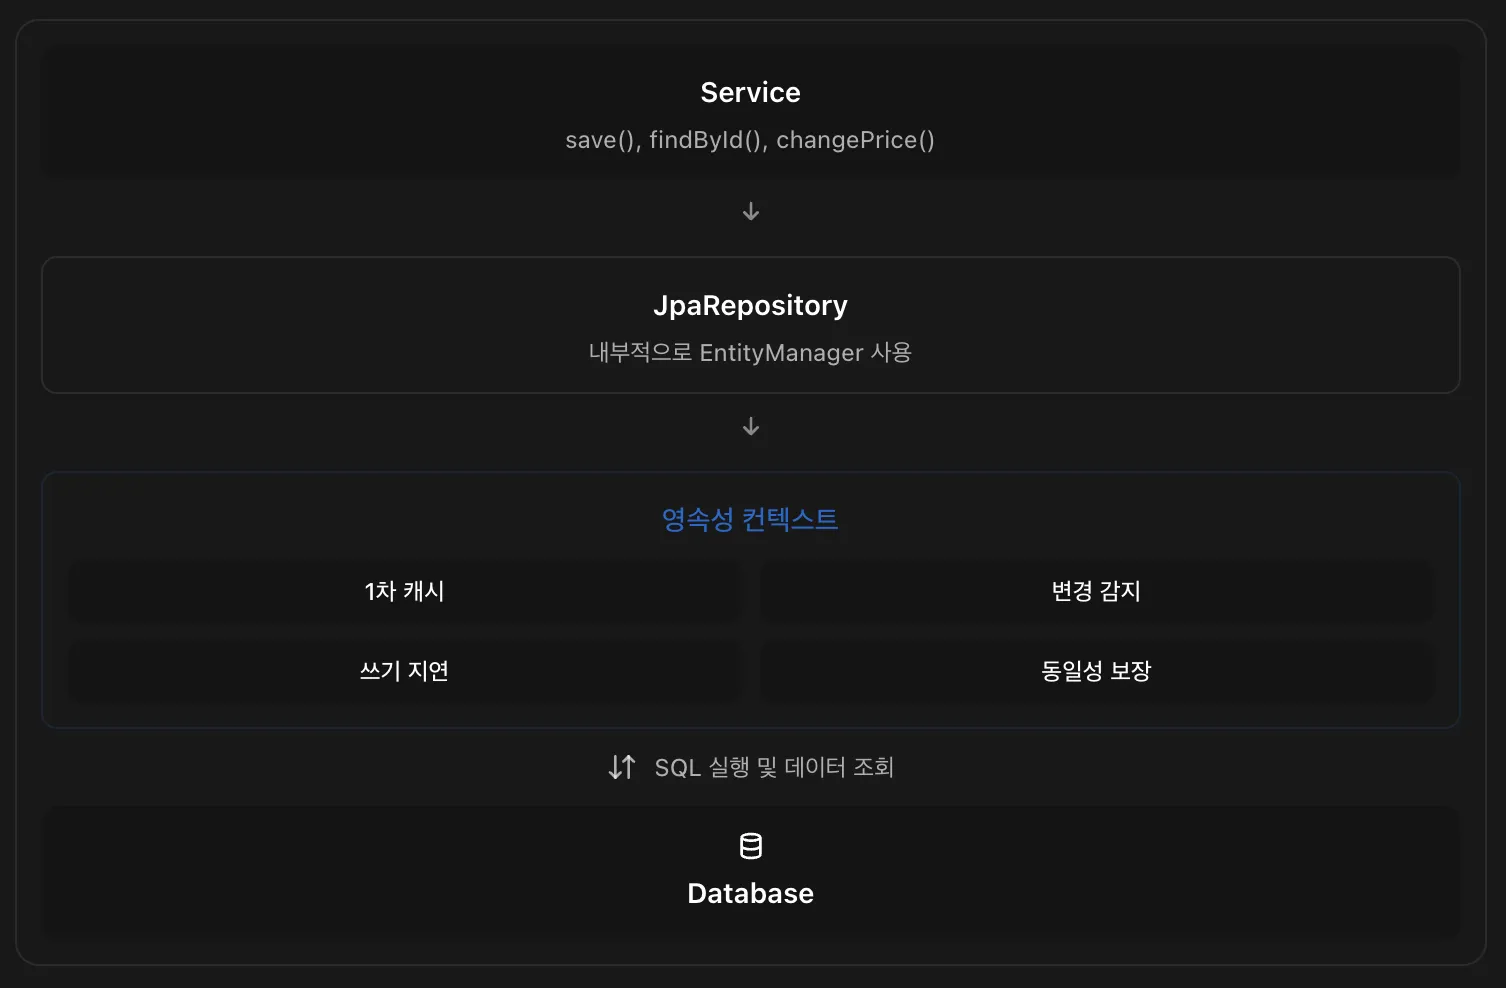
영속성 컨텍스트의 핵심 기능은 다음 네 가지야.
| 기능 | 설명 |
|---|---|
| 1차 캐시 | ID 기준으로 엔티티를 관리 |
| 동일성 보장 | 같은 영속성 컨텍스트에서 같은 ID의 엔티티는 동일 객체 |
| 변경 감지 | 엔티티 상태 변경 시 UPDATE SQL 생성 |
| 쓰기 지연 | SQL 실행을 flush까지 지연할 수 있음 |
엔티티 생명주기
| 상태 | 의미 |
|---|---|
| 비영속(Transient) | new로 생성했지만 JPA가 관리하지 않는 객체 |
| 영속(Managed) | 영속성 컨텍스트가 관리하는 객체 |
| 준영속(Detached) | 관리되다가 영속성 컨텍스트에서 분리된 객체 |
| 삭제(Removed) | 삭제 대상으로 지정된 객체 |
여기서 중요한 것은 영속 상태라는 말이 DB에 저장이 완료되었다는 뜻은 아니라는 것이야.
3. findById()만 해도 영속 상태가 되는가?
맞아. JpaRepository.findById()는 내부적으로 EntityManager를 사용하므로 조회한 엔티티가 영속성 컨텍스트에서 관리돼.
@Transactional
public void update(Long id) {

    Product product = productRepository.findById(id)
            .orElseThrow();

    product.changePrice(20000);
}
이 코드에서는 save()를 호출하지 않아도 DB에 UPDATE가 발생할 수 있어.
왜냐하면 JPA가 관리 중인 객체의 변경을 감지하기 때문이야.
findById()
    ↓
SELECT SQL 실행
    ↓
엔티티를 영속성 컨텍스트에서 관리
    ↓
changePrice(20000)
    ↓
트랜잭션 커밋 과정에서 변경 감지
    ↓
UPDATE SQL 실행
단, 이 동작은 쓰기 가능한 트랜잭션 안에서 엔티티가 영속 상태로 유지되는 상황을 전제로 해.
@Transactional이 없으면 Repository 조회 트랜잭션이 종료되면서 엔티티가 준영속 상태가 될 수 있어. OSIV가 켜져 있는 경우에는 관리 범위가 달라질 수 있고.
4. Dirty Checking(변경 감지)이란?
영속성 컨텍스트가 관리하는 엔티티의 이전 상태와 현재 상태를 비교해 변경 사항을 DB에 반영하는 기능이야.
예를 들어 다음과 같아.
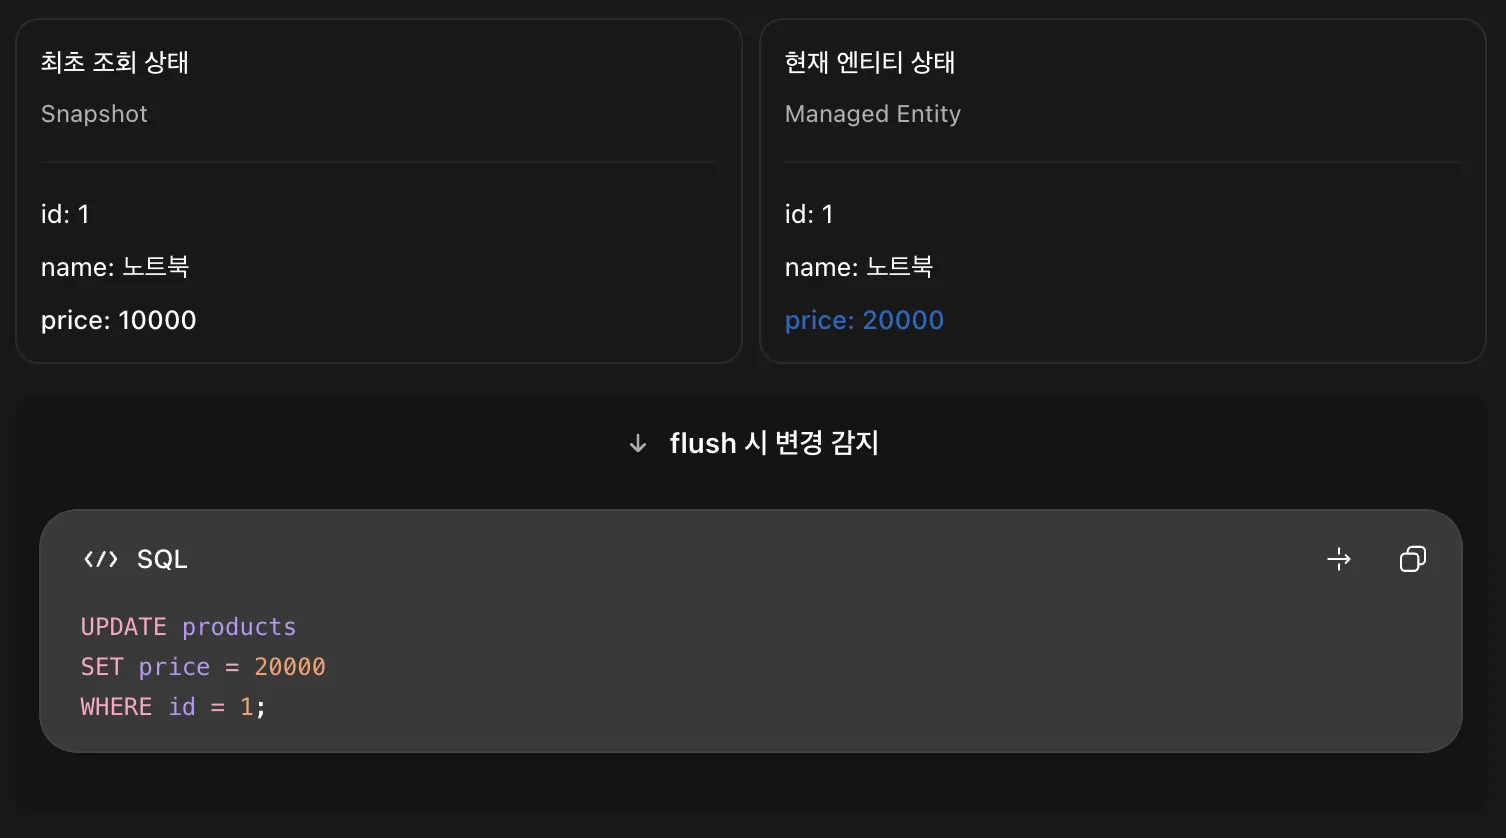
Hibernate는 일반적으로 스냅샷 비교 등의 방식으로 변경을 감지해. 바이트코드 향상 같은 다른 추적 방식도 사용할 수 있어.
따라서 영속 엔티티를 수정할 때는 save()를 다시 호출할 필요가 없어.
5. save()와 saveAndFlush()의 차이
처음 질문했던 핵심 내용이야.
productRepository.save(product);save()는 엔티티 저장 작업을 수행하지만 INSERT SQL이 즉시 실행된다는 보장은 없어.
반면,
productRepository.saveAndFlush(product);saveAndFlush()는 저장 작업을 수행한 후 flush()를 호출해 보류된 SQL을 DB에 실행하도록 해.
| 구분 | save() | saveAndFlush() |
|---|---|---|
| 엔티티 저장 | O | O |
| flush 즉시 요청 | X | O |
| INSERT 즉시 실행 | 상황에 따라 다름 | 일반적으로 실행 |
| 트랜잭션 커밋 | X | X |
| DB 제약조건 검사 | SQL 실행 시 | 일반적으로 호출 시점 |
주의: GenerationType.IDENTITY는 ID를 얻기 위해 save() 시점에 INSERT를 실행할 수 있어.
또한 Spring Data JPA의 save()는 신규 엔티티인지에 따라 내부적으로 persist() 또는 merge()를 호출해.
6. flush와 commit은 어떻게 다른가?
가장 중요한 부분이야.
flush는 SQL 실행이고, commit은 트랜잭션 확정이야.
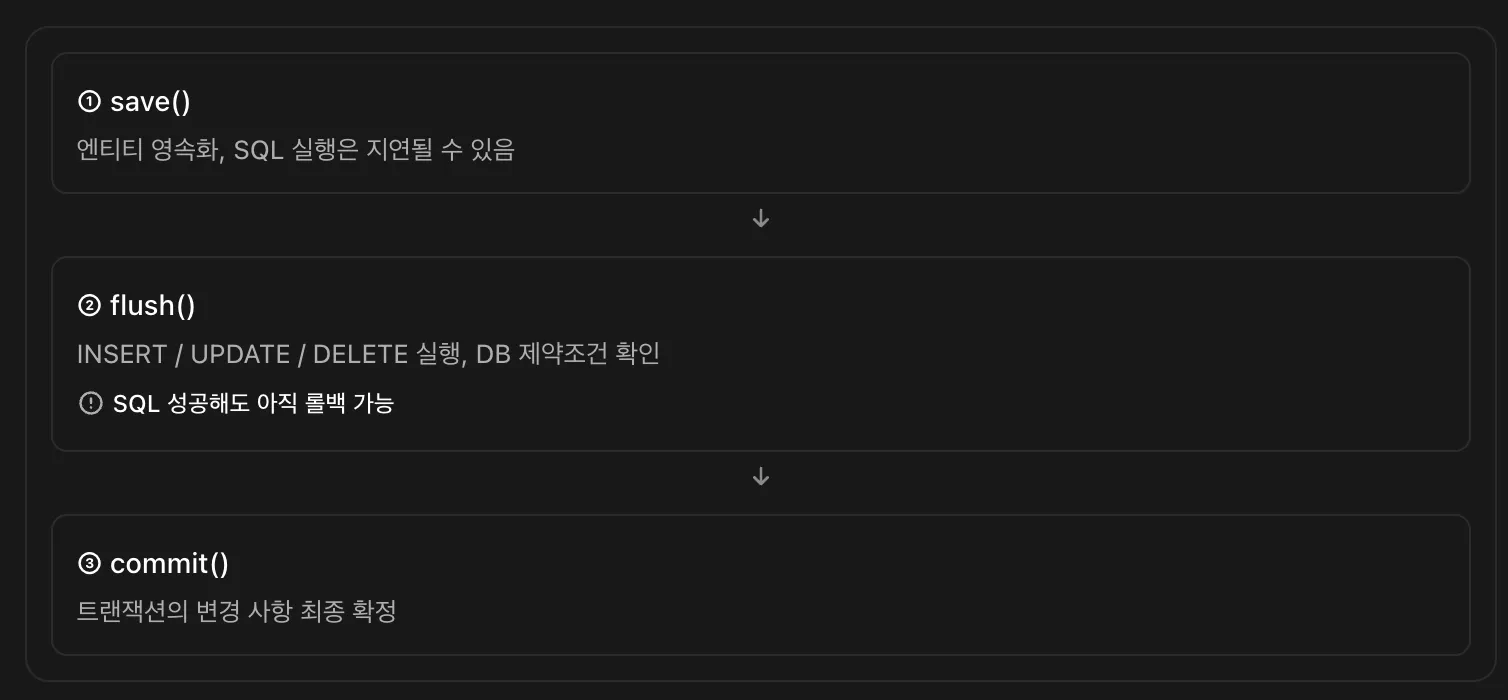
| 구분 | flush | commit |
|---|---|---|
| SQL 실행 | O | 필요하면 flush 수행 |
| DB 변경 | 미커밋 상태로 반영 | 최종 확정 |
| 다른 트랜잭션에서 조회 | 일반적으로 불가능 | 일반적으로 가능 |
| 롤백 가능 | O | 성공한 커밋은 롤백 불가 |
예를 들어:
@Transactional
public void register() {
    productRepository.saveAndFlush(product);

    throw new RuntimeException("오류");
}
INSERT는 실행되었지만 이후 예외가 발생했기 때문에 전체 트랜잭션은 롤백돼.
추가로 flush는 commit 시점뿐 아니라 JPQL 실행 전이나 명시적인 flush() 호출 시에도 발생할 수 있어.
7. @Transactional과 AOP의 관계
Spring의 @Transactional은 일반적으로 AOP 프록시를 사용해 트랜잭션을 관리해.
@Transactional
public void register() {
    Product product = Product.register("노트북", 10000);

    productRepository.save(product);

    // 메서드 종료
}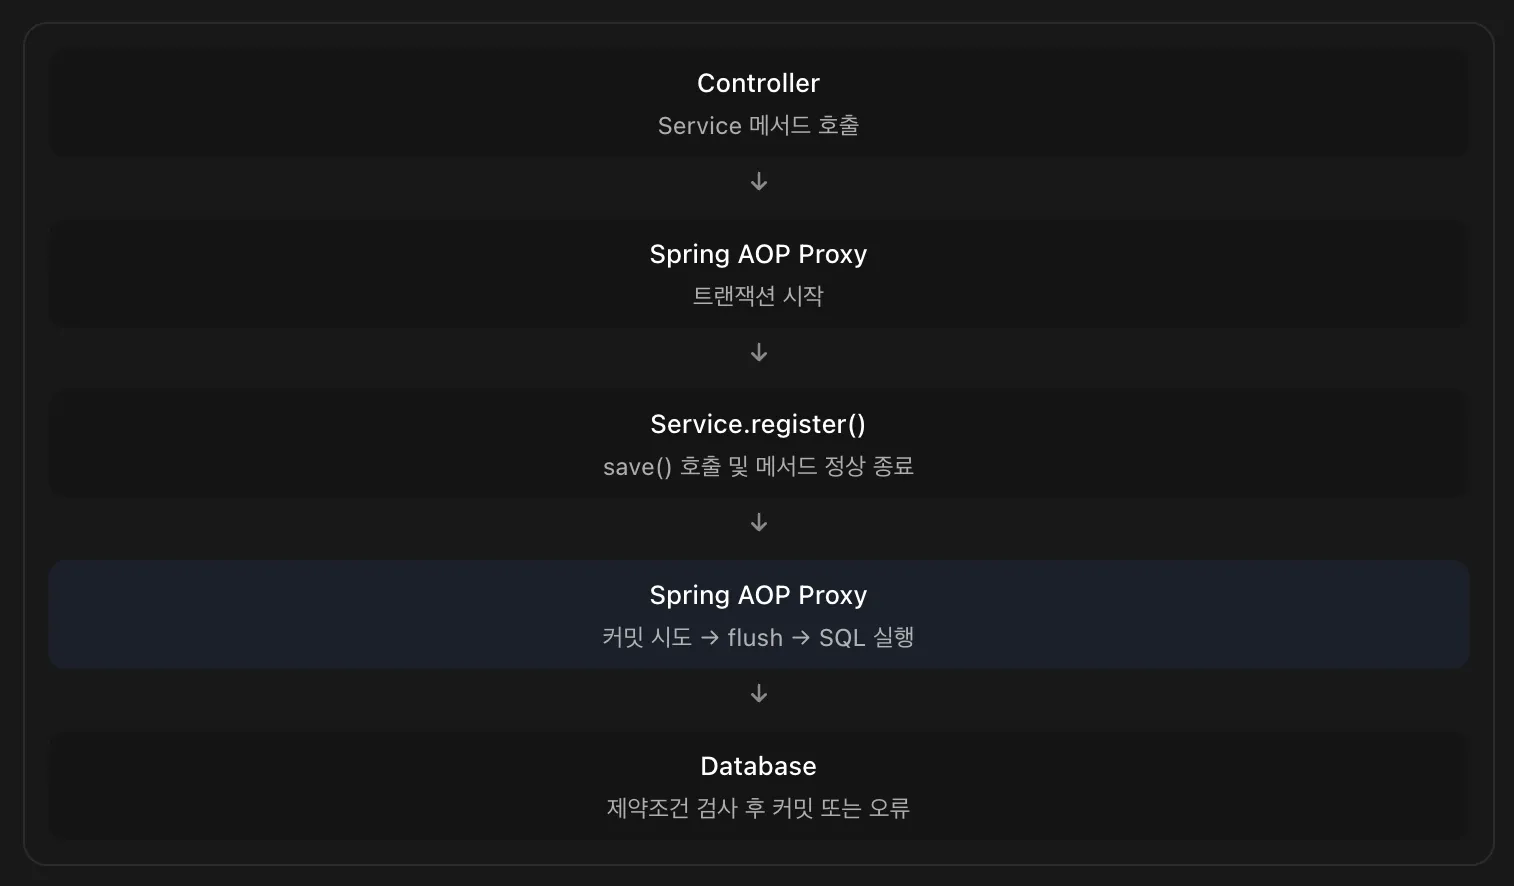
따라서 Service 메서드가 정상 종료되어도 AOP 프록시가 커밋하는 과정에서 오류가 발생할 수 있어.
다만 이는 외부에서 프록시를 거쳐 호출되는 일반적인 트랜잭션 흐름이야. 같은 클래스 내부의 자기 호출 등에서는 AOP 적용 방식에 주의해야 해.
8. 왜 saveAndFlush()로 UNIQUE 예외를 잡는가?
DB에 다음 제약조건이 있다고 가정해 보자.
@Column(unique = true)
private String name;
그리고 이미 "노트북"이라는 상품이 존재해.
save()를 사용할 경우
try {
    productRepository.save(product);
} catch (DataIntegrityViolationException e) {
    throw new DuplicateProductException();
}
INSERT SQL이 지연된다면 서비스 메서드 내부에서는 오류가 발생하지 않을 수 있어.
save() 호출
  ↓
try-catch 종료
  ↓
Service 메서드 종료
  ↓
AOP 프록시에서 flush
  ↓
INSERT 실행
  ↓
UNIQUE 제약조건 위반
이미 try-catch 범위를 벗어났기 때문에 서비스 내부에서 예외를 변환하지 못할 수 있는 거야.
saveAndFlush()를 사용할 경우
try {
    productRepository.saveAndFlush(product);
} catch (DataIntegrityViolationException e) {
    throw new DuplicateProductException();
}
saveAndFlush() 호출
↓
flush → INSERT 실행
↓
UNIQUE 제약조건 위반
↓
catch에서 예외 변환
↓
트랜잭션 롤백그래서 saveAndFlush()를 사용하면 일반적인 즉시 검사 DB 제약조건 위반을 더 일찍 확인할 수 있어.
다만 모든 DataIntegrityViolationException이 이름 중복은 아니기 때문에, 정확하게 구분하려면 제약조건 이름이나 DB 오류 원인을 확인하는 것이 좋아.
9. 동시성 문제와 UNIQUE 제약조건
두 트랜잭션이 같은 이름을 등록한다고 가정하자.
트랜잭션 A           트랜잭션 B
    |                    |
save("노트북")       save("노트북")
    |                    |
 flush()              flush()
    |                    |
 INSERT               INSERT
    |                    |
 commit             UNIQUE 충돌
실제 DB에서는 충돌한 트랜잭션이 상대 트랜잭션의 종료를 기다릴 수도 있어.
여기서 구분해야 할 개념은 다음과 같아.
flush()는 SQL 실행 시점을 조절해.UNIQUE제약조건은 중복 데이터의 최종 저장을 방지해.commit()은 트랜잭션을 확정해.
즉, 동시성 환경에서 중복 저장을 막는 것은 saveAndFlush()가 아니라 DB의 UNIQUE 제약조건이야.
10. 공부할 때 꼭 기억할 7문장
- ORM은 객체와 테이블을 매핑하고, 영속성 컨텍스트는 엔티티의 상태를 관리한다.
JpaRepository.findById()로 조회한 엔티티는 일반적으로 영속성 컨텍스트에서 관리된다.- 영속 엔티티는 Dirty Checking 덕분에 수정할 때
save()를 다시 호출하지 않아도 된다. save()는 SQL을 지연할 수 있지만saveAndFlush()는 flush를 명시적으로 호출한다.flush()는 SQL 실행,commit()은 트랜잭션 최종 확정이다.@Transactional은 일반적으로 AOP 프록시를 통해 메서드 실행 전후로 트랜잭션을 관리한다.saveAndFlush()는 DB 제약조건 위반을 조기에 감지하기 위한 수단이지, 동시성 제어 수단은 아니다.
11. 다음에 연결해서 공부할 주제
지금까지의 개념을 이해했다면 다음 순서로 공부하면 자연스럽게 이어져.
| 우선순위 | 주제 | 핵심 질문 |
|---|---|---|
| 1 | 트랜잭션 격리 수준 | 다른 트랜잭션의 변경을 언제 볼 수 있는가? |
| 2 | MVCC | 읽기와 쓰기가 서로 덜 방해받도록 어떻게 동작하는가? |
| 3 | 낙관적 락과 비관적 락 | 동시 수정 충돌을 어떻게 처리하는가? |
| 4 | JPA의 N+1 문제 | 연관 엔티티를 조회할 때 SQL이 왜 반복되는가? |
| 5 | Fetch Join과 EntityGraph | 연관 엔티티를 효율적으로 조회하는 방법은? |
전체 흐름을 한 줄로 압축하면:
ORM 매핑 → EntityManager → 영속성 컨텍스트 → 엔티티 관리 및 변경 감지 → flush(SQL 실행) → commit(트랜잭션 확정)
이 흐름을 중심으로 JPA를 이해하면 개별 메서드를 외우는 것보다 실제 코드가 어떻게 동작하는지 훨씬 정확하게 판단할 수 있어.